sandbox
sandbox
本文处于WIP;后续会找时间再更新喵
sandbox大概是一个比较好玩的物件
需求主要如下
- 云上Agent在服务器上运行
- RL场景下的Agent
前置
对于Sandbox而言,特点非常的鲜明
- 沙盒创建请求是脉冲式、突发的;
- 启动后 CPU 大部分时间闲置,内存却需要持续驻留;
- Agent 执行环境种类多,基础镜像复用率低;
- 任务执行时间长,训练还可能因资源抢占而中断
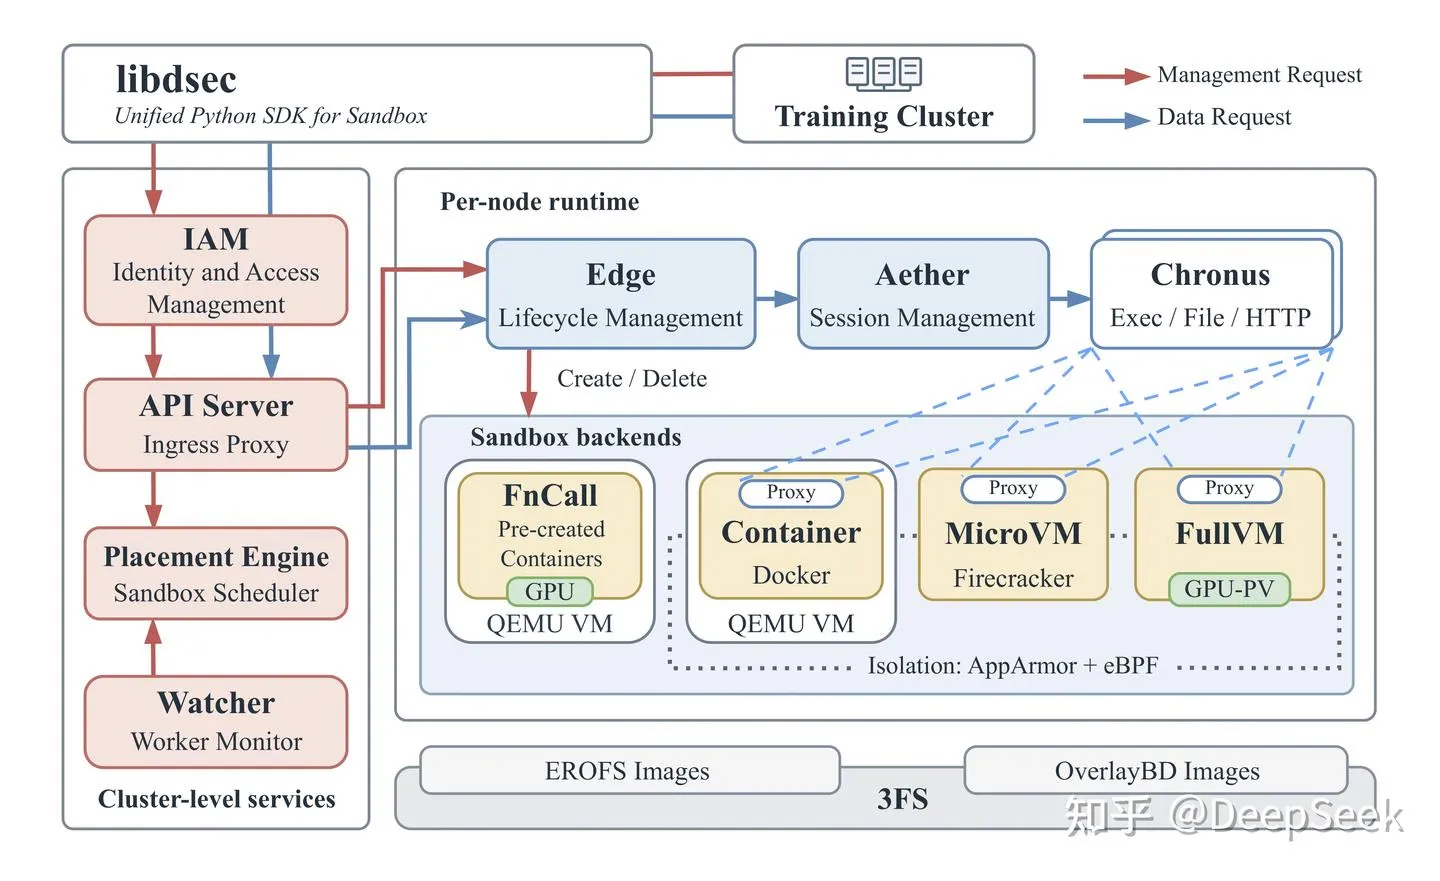
想要最完整的了解 Sandbox 用来做什么,可以看看DSec的样子
存储
存储得从文件系统开始入手,调用open("/data/file.txt") 之后抽象依次从应用层到底层
- 应用程序(open()/ read()/ write系统调用) ->
- VFS虚拟文件系统层(统一的文件操作接口) ->
- 具体文件系统(XFS/ ext4/ btrfs)(逻辑块 -> 物理块 映射)->
- 物理存储设备(SDD/ HDD/ NVMe)
通识
- 文件系统不会按字节读写磁盘,而是按块(Block) 为单位;常见块大小为 4KB
- 一个 inode 对应一个文件/目录;存储文件元数据(inode 编号、文件类型、权限、大小、时间戳)(指向数据块:文件名和文件内容)
- 一个 inode 需要记录”文件内容分布在哪些数据块上”;但inode大小有限,不可能直接存下大文件的所有块号;因此采用 多级索引
- 目录本身也是一种文件,但它的内容是目录项(Directory Entry, dentry) 的列表;(文件名和文件内容通过 inode 间接关联)
(每个目录项包含 文件名 -> inode 编号)
访问data/temp.txt 内核解析过程如下
- 从 根目录的 inode 开始 -> 从根目录的数据块中找到 data 这个目录项 -> 获取其 inode编号 -根据 inode找到其数据块 -> 从data目录的数据块中找到 temp.txt 的 inode -> 获取数据块指针,从数据块中读取文件内容
文件系统(xfs/ext4)
以 绿导师的说法;文件系统 -> 磁盘上的数据结构;
因此我们可以根据通识部分的内容 很浅显的了解一下 xfs & ext4
ext4
- 预分配 inode 表;ext4 在格式化时就会固定分配好所有inode(所以如果文件数量超过预分配的 inode数,即使磁盘还有空间也无法创建新文件)
- 块映射;inode 通过多级索引记录文件的数据块的位置,每个数据块在inode占一个条目
- 延迟分配;ext4写入数据时,不立即分配数据块,而是先写入 page cache,等实际刷盘时再分配
xfs
- 动态分配 inode;
- 用 extent (区段)记录一段连续的数据块(结构:[起始块号,长度])
- XFS 将文件系统划分为多个分配组(AG),每个 AG 有独立的 inode 空间和数据空间(方便并发)
虚拟化
gVisor
google开源的Linux内核,塞在 容器和宿主机之间,跑在一个独立的 OCI runtime runsc 里,和 runc 平级;因此对于 docker/ K8s 都可以实现无感切换;
在用户空间重新实现 Linux 系统调用接口,拦截所有应用行为,不需要硬件虚拟化
- Sentry:采用Go重写的 Linux 内核,自己管 PID表,内存管理,调度,信号,namespace,文件系统,netstack
- 用软件隔离,灵活度高,但 syscall 兼容性有边界
gVisor 代码与文档入口:
| 路径 | 说明 |
|---|---|
| runsc/ | OCI运行时入口 |
| pkg/sentry/ | 用户态内核实现 |
| pkg/tcpip/ | netstack实现 |
| gvisor.dev | 官方文档 |
Firecracker
有AWS造的 microvm,相对于完整的QEMU,只保留了 4 个 VirtIO 设备
- 网卡(net)
- 磁盘(block)
- 串口(console)
- 定时器(timer)
然后稍微了解了一下Firecracker的接口;
- 采用 UDS 传输,语义上是标准 HTTP/JSON
- Firecracker API 的每个端点都标注了 Pre-boot only(VM 未启动时(配置类资源)) 或 Post-boot only(只允许 PATCH 做受限的部分更新)
- 设计上把配置(PUT)、运行调控(PATCH)、快照(含 UFFD 懒加载与外部脏页读取)拆成了可组合的原语
SOCK=/tmp/fc-test.sock
# ① 内核curl -s --unix-socket $SOCK -X PUT http://localhost/boot-source -d '{ "kernel_image_path": "/opt/vmlinux", "boot_args": "console=ttyS0 reboot=k panic=1 pci=off"}'
# ② 机器规格(vcpu 1-32,默认 1 vCPU / 128 MiB)curl -s --unix-socket $SOCK -X PUT http://localhost/machine-config -d '{ "vcpu_count": 2, "mem_size_mib": 512}'
# ③ 根文件系统curl -s --unix-socket $SOCK -X PUT http://localhost/drives/rootfs -d '{ "drive_id": "rootfs", "path_on_host": "/opt/rootfs.ext4", "is_root_device": true, "is_read_only": false}'
# ④ 网卡(host_dev_name 是宿主机上已建好的 TAP)curl -s --unix-socket $SOCK -X PUT http://localhost/network-interfaces/eth0 -d '{ "iface_id": "eth0", "host_dev_name": "tap0", "guest_mac": "06:00:AC:10:00:02"}'
# ⑤ 点火curl -s --unix-socket $SOCK -X PUT http://localhost/actions -d '{ "action_type": "InstanceStart"}'
# ⑥ 确认状态curl -s --unix-socket $SOCK http://localhost/# → {"app_name":"Firecracker","id":"...","state":"Running","vmm_version":"1.15.1"}sandbox
从K8s的 Sandbox的 CRD来说;
SandboxTemplate -> SandboxWarmPool(预热) -> SandboxClaim -> Sandbox(实例)
很自作主张的,将一个 Sandbox系统分成 四个部分
Agent Sandbox = 隔离底座 + 快照 + 网络管控 + 控制面
隔离底座
runc (容器, 共享内核) ── gVisor (用户态内核, syscall 拦截) ── Kata (K8s 里的 VM) ── microVM (专用 VMM)
AgentENV(kvcache-ai/AgentENV)采用的是microVM的firecracker,沿用上游 VMM,自己只驱动 REST API;相对于CubeSandbox来说,并没有像CubeVM(RustVMM + Cloud Hypervisor 定制),<60ms 冷启动和完全可控的恢复路径;
快照
rootfs
镜像怎么变成可写的盘
- 层模型(AgentENV):rootfs = lower 层栈 + writable upper,写全进 upper。seal upper → 新 lower。优点是层可跨快照复用、可去重、可懒加载、可 P2P 分发;代价是要自己实现 LSMT 格式和索引
- reflink 模型(CubeSandbox):整个 rootfs 是一个文件系统,FICLONE ioctl 让新快照共享 extent。优点是O(1)、内核帮你做、实现极简;代价是层间 dedup 粒度粗、跨节点分发是整个文件系统增量
内存快照
捕获:VM 运行中/暂停时,怎么拿到内存?
恢复:怎么让新 VM 快速”拥有”这份内存?
方案谱系(从 naive 到工程化):
-
全量内存 dump(原生 FC/E2B 早期)
捕获=写几个 GB 文件,恢复=全量读回。慢,存储贵。
-
uffd lazy restore(Firecracker 原生)
恢复时不读内存,guest 缺页时 VMM 通过 uffd 向宿主要页。
AgentENV 把这条路径标为 dead_code,uffd-core crate 整个移出 workspace。
为什么弃用:uffd 每次缺页一次 IPC,首访延迟高,且自己成了内存路径的单点。
-
块设备 + mmap COW(AgentENV 的方案,已验证)
捕获: FC Pause → 拿 dirty-memory-ranges(fork patch 的 API)
→ process_vm_readv 直接从 FC 进程读脏页
→ 写成 overlaybd 层(增量 只写脏页)
恢复: 内存层栈 → 只读 ublk 块设备 → FC 以 File backend mmap 它
→ guest 首次写页时内核 COW 到匿名内存 → 底层设备永不被改
加成: 同模板的所有沙箱共享同一内存设备 → page cache 复用
- startup pack 预热首批要读的页
-
脏页增量 + reflink(CubeSandbox)
只持久化 dirty anonymous pages,未变页通过 reflink 与模板共享;
CubeShim 做”原地快照”支撑 auto-pause;恢复走 RustVMM restore 路径
K8s agent-sandbox: 无(roadmap 里的 hibernation 就是想做这个)
内存恢复的核心权衡是”恢复时读多少”vs”运行时缺页多快”。AgentENV 用块设备把”恢复”摊销成 page cache 页的常态 I/O(还白拿了跨沙箱共享),CubeSandbox 用”只存脏页 + 模板共享”压缩存储。两种都比 uffd 的工程表现好
对于 网络管控 + 控制面;
前者主要几种技术手段,相对来说都很常见
- 每沙箱 netns:VM eth0↔tap↔veth↔宿主;宿主 iptables MASQUERADE
- 纯 eBPF:TAP 上三个 TC程序(from_cube/from_world/from_envoy)
- CNI pod 网络 + NetworkPolicy
然后采用reverse proxy + 路由头,就可以接入数据面,把外部请求送入 Sandbox
后者根据具体情况用go自建 schedule 即可,更多技术点更倾向于业务逻辑上
Final
因此对于完成一个sandbox来说,快照/存储 + 虚拟化手段应该才是技术选型上的要求,而对于 自己造VM,可能会有点过于奢侈了,对于Linux底层的逻辑也需要更加的熟悉,笔者还是个菜鸡,因此只能到这里了…
如果后面会的更多或许还能写的更多吧
评论